
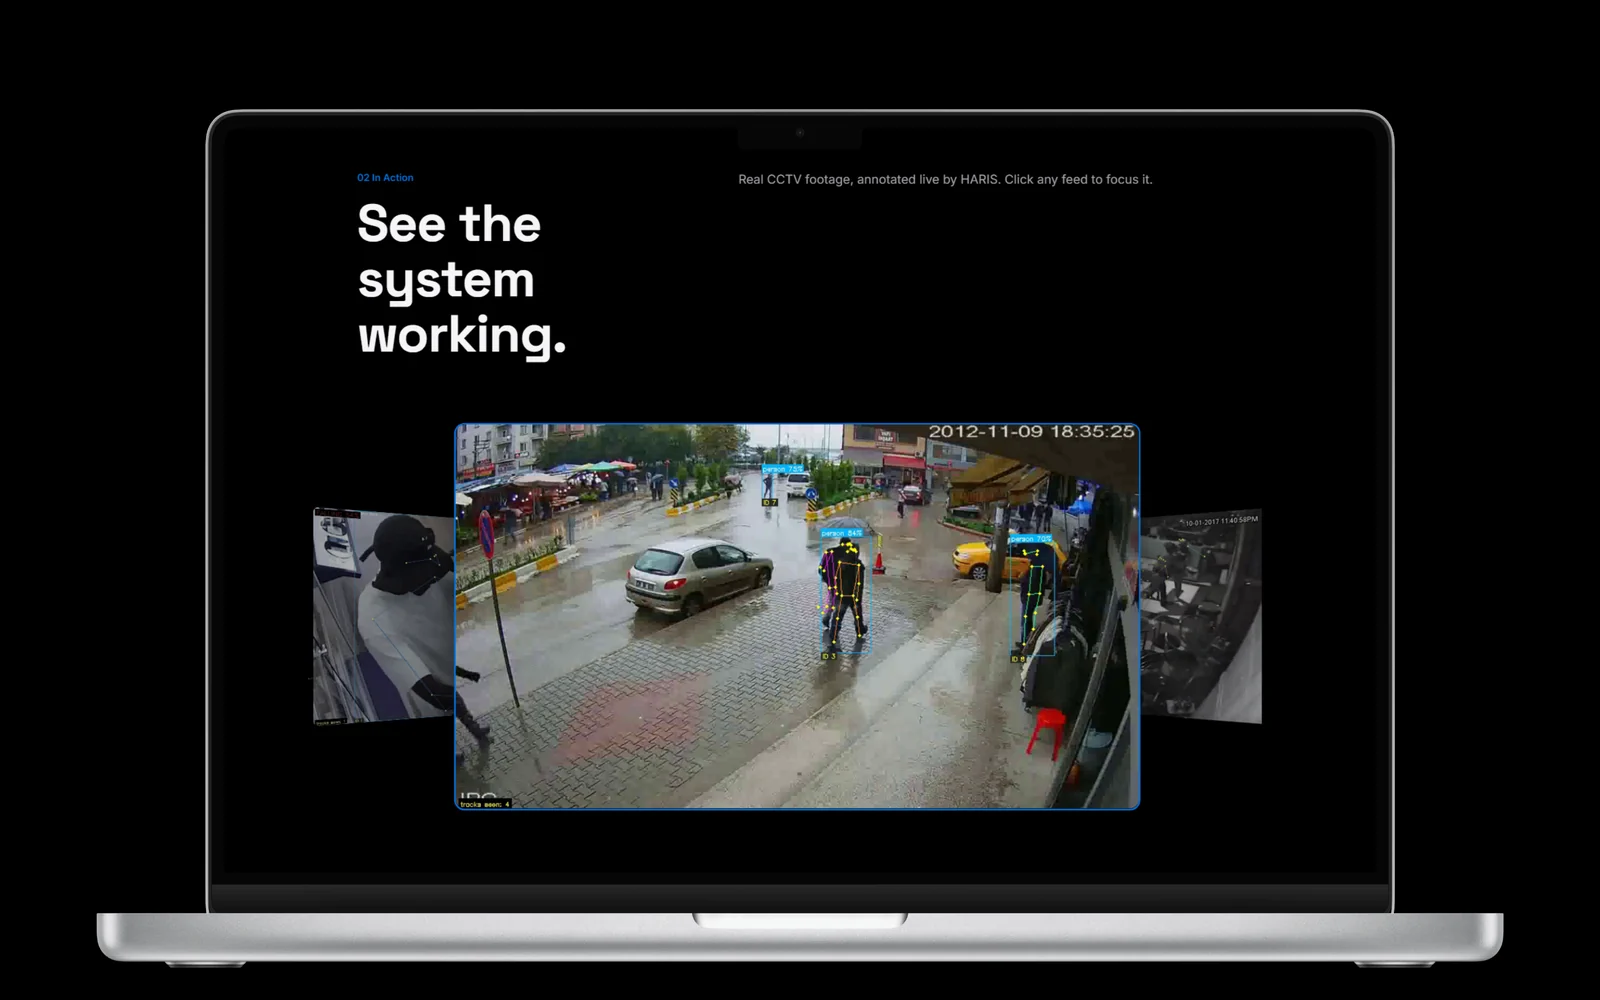
المشكلة
من يراقب ست عشرة شاشة ستفوته أشياء. والكشف من إطار واحد يغمره بالإنذارات الخاطئة، ففي إطار واحد قد تبدو المصافحة كأنها ضربة.
ما بنيته
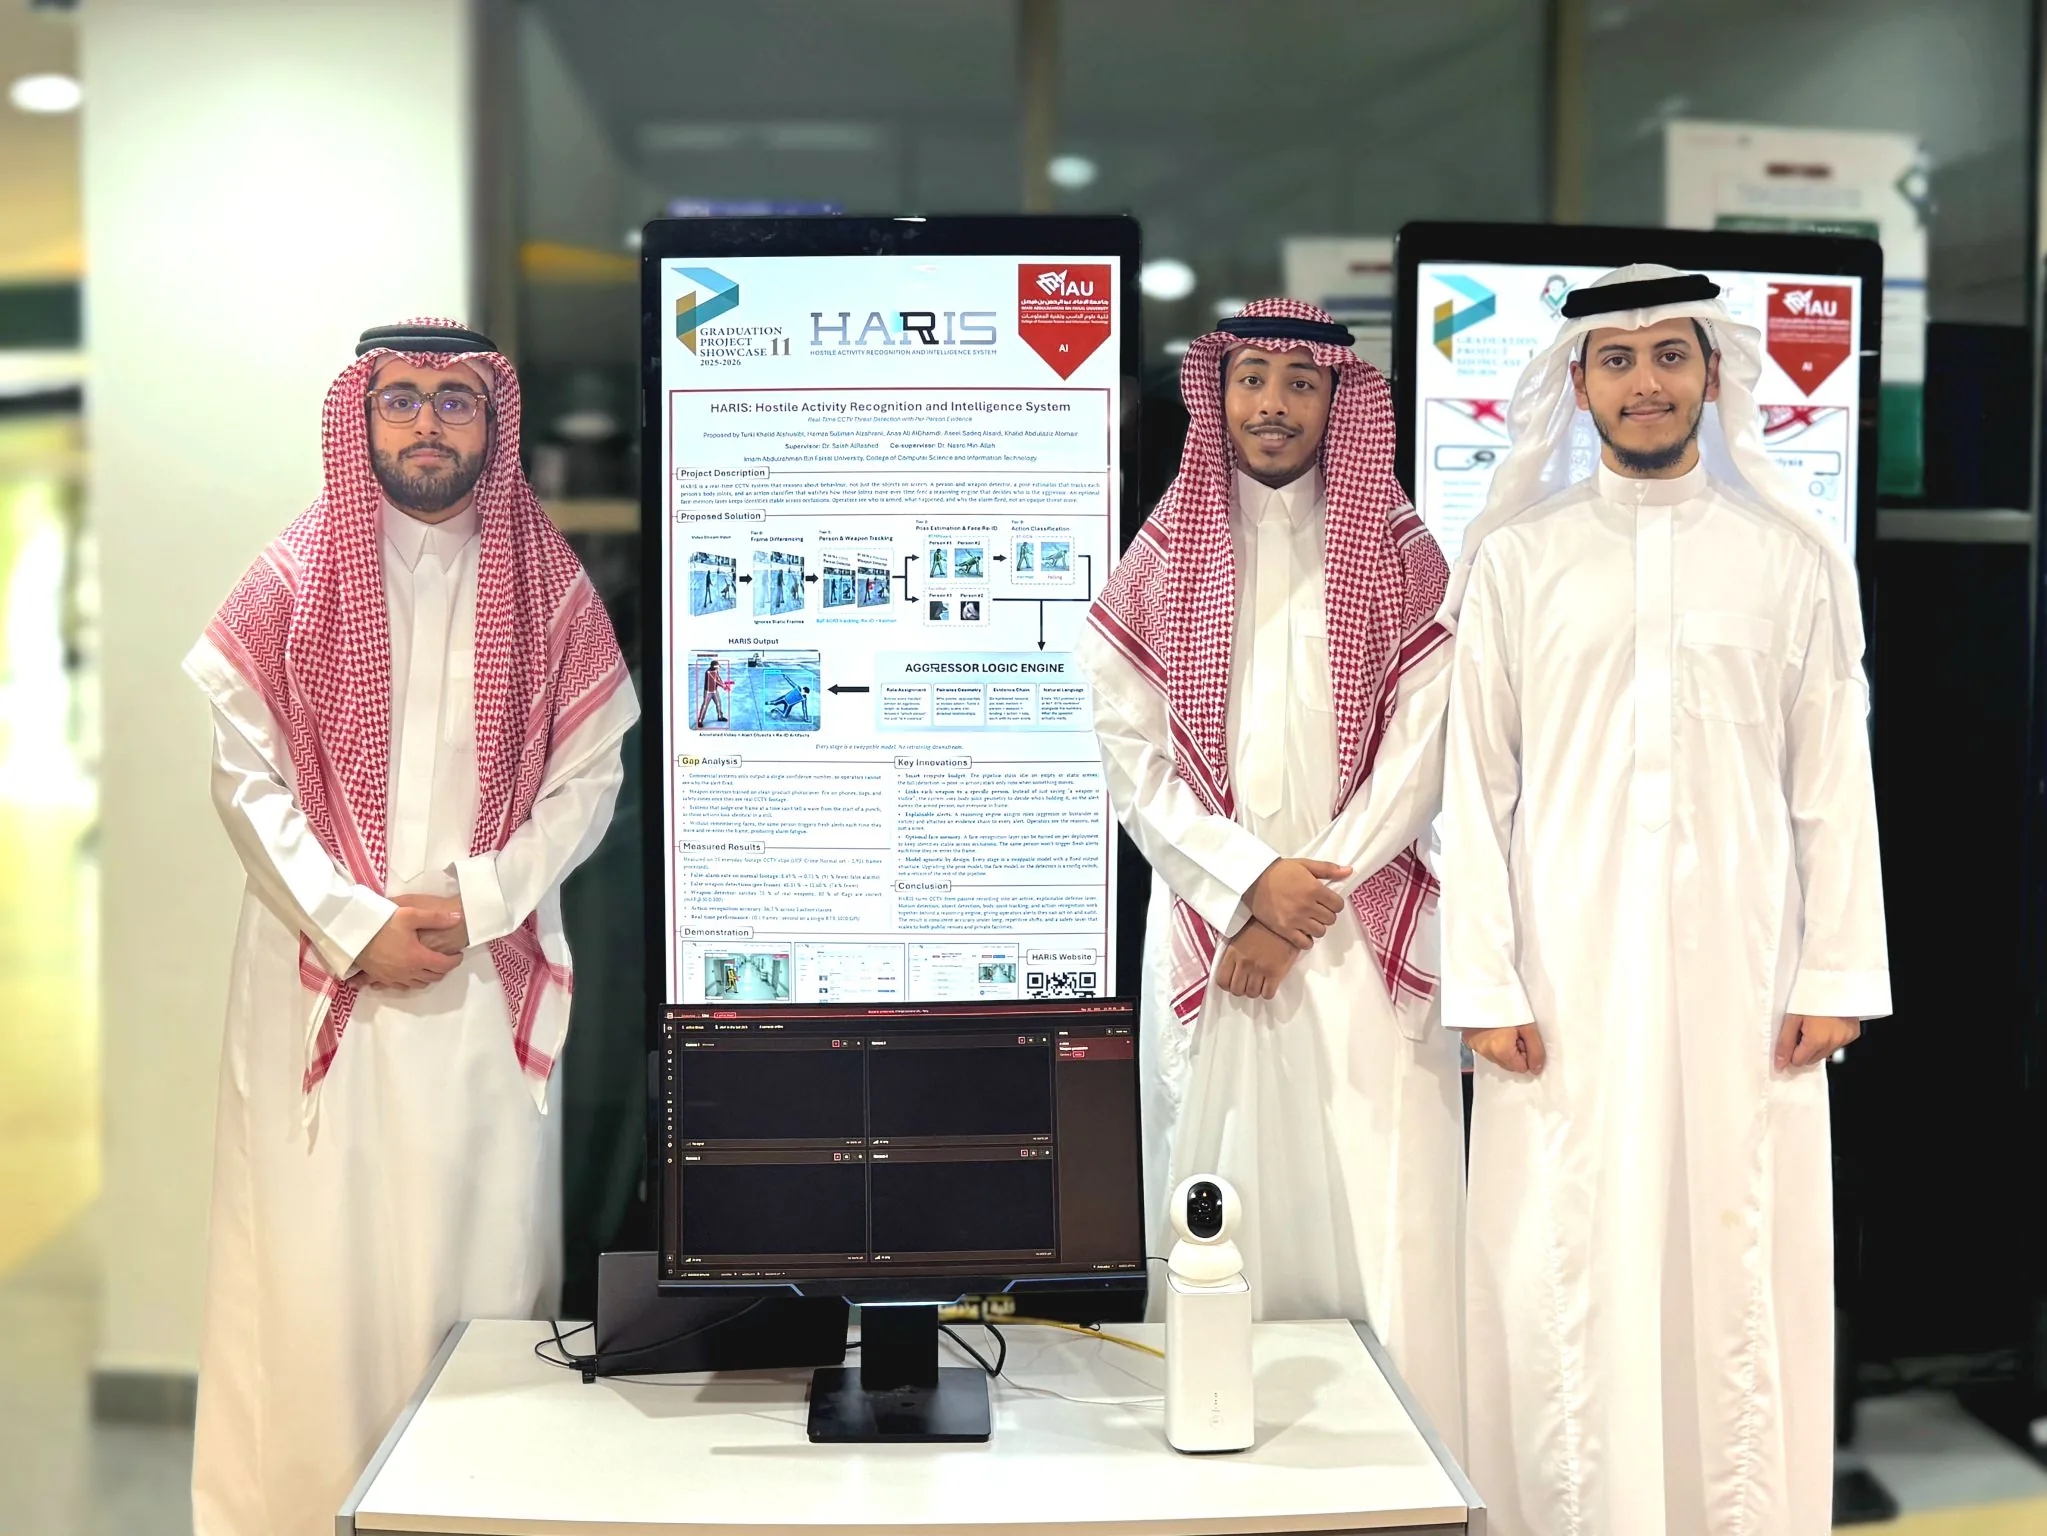
قدتُ فريقاً من خمسة مطورين وصممتُ النظام سلسلةً من النماذج، يتولى كل منها جزءاً من المشكلة. تمرر كل طبقة أدلة منظمة إلى التي تليها، فيمكن تتبع أي تنبيه إلى المرحلة التي أطلقته.
- الطبقة 0: بوابة حركة تقارن الإطارات ولا تفتح الاستدلال إلا عند وجود حركة.
- الطبقة 1: كاشفا RT-DETR، أحدهما مضبوط على الأسلحة النارية والسكاكين والآخر للأشخاص.
- الطبقة 2: تتبع BoT-SORT مع هياكل RTMPose، بسبع عشرة نقطة لكل شخص.
- الطبقة 3: تصنيف الأفعال بنموذج ST-GCN على نوافذ من 30 إطاراً، تنتهي بسلسلة أدلة JSON قابلة للتدقيق.
كيف قيس
هذه هي الأرقام كما وردت في الورقة البحثية.
- انخفضت الإنذارات الخاطئة للأسلحة في كل إطار من 8.49% إلى 0.75%.
- انخفضت مقاطع الفيديو السليمة المُبلغ عنها من 6 من 25 إلى 2 من 25.
- مقياس F1 الشامل 0.745 على فئات إطلاق النار والاعتداء والشجار في UCF-Crime (الدقة 0.812، الاستدعاء 0.688).
- 10.1 إطار في الثانية وزمن استجابة 154.5 مللي ثانية عند المئين 95 على RTX 3070.
مجموعة البيانات
وفي أثناء العمل وجدنا أن معايير كشف الأسلحة العامة تتكرر فيها الصور بين مجموعات البيانات، فتتضخم دقتها. نشرنا مجموعة من 6,102 صورة من 7 مصادر، بتقسيمات GroupKFold فُحصت من هذا التسرّب، برخصة CC BY 4.0 ومعرّف DOI، على Kaggle وHugging Face. والورقة البحثية عنها قيد المراجعة في IEEE Access.
مصمم للمشغّل
صُممت لوحة التحكم لمن يراقب: طبقة جسم مستمرة، ومنزلق حي لعتبة الأسلحة، وخريطة لكثافة التهديد على شريط التقديم، وربط كل سلاح بحامله، وتنبيهات تأتي مع أدلتها.
من الميدان
التقنيات
- المجال
- الرؤية الحاسوبية
- التقنيات
- الروابط
- عرض المشروعمجموعة البيانات